
LLM構築サービスLLM構築サービス
社内専用のLLMを、
現実的なコストと期間で構築します
LLM(大規模言語モデル)を社内で動かせば、図面・手順書・品質記録などの社内データを外部へ出さずにAIで活用できます。 アイテックは、機器の選定から推論環境の構築、社内データを使うRAGまで、まとめて構築いたします。
- 中堅製造業ならAMD Ryzen AI MAX+ 395 のユニファイドメモリ型で十分
- 部門規模ならWindows機と弊社開発の軽量LLMで運用可能
- 構築はおまかせ機器選定・推論環境・RAGまで一括対応
NVIDIAは高性能。
ただし、導入に時間とコストがかかります
LLMを動かす機器としては、NVIDIA製GPUがお奨めです。 ただし現在はGPUの在庫不足と価格の高さから、導入までに時間とコストがかかります。 大きなモデルを載せるにはGPUを複数枚そろえる必要があり、機器代だけで400万円を超えることも珍しくありません。
| 構成 | 主な仕様 | 参考価格 |
|---|---|---|
| GPUAMD Ryzen Threadripper PRO + NVIDIA RTX 5090 ×3枚 | GPUメモリ 32GB ×3枚 | 400万〜500万円 |
| GPUHP OMEN MAX 45L(RTX 5090 標準搭載)×3台 | 1台 140万円 ×3台 | 420万円 |
| 参考Apple Mac Studio(M5 Max) | 128GBユニファイドメモリ・2TB | 103万1,800円 |
| 推奨GMKtec EVO-X5 Pro(AMD Ryzen AI MAX+ 395) | 192GBユニファイドメモリ・2TB | 103万9,840円 |
| 推奨GMKtec EVO-X2(AMD Ryzen AI MAX+ 395) | 128GBユニファイドメモリ・2TB | 58万3,000円 |
価格は機器本体の参考価格です(EVO-X5 Proは2026年9月28日の発売時価格)。 時期・構成・在庫状況により変動します。構築作業の費用は別途お見積りいたします。
中堅製造業なら、
AMD Ryzen AI MAX+ 395 のユニファイドメモリ型で十分です
AMD Ryzen AI MAX+ 395 は、CPUとGPUが大容量のメモリを共有する「ユニファイドメモリ」型です。 GPUを何枚も積まなくても、メモリの大部分をGPUに割り当てて大きなモデルを動かせます。 弊社では gpt-oss-120b を実際に運用しています。
EVO-X5 Pro(192GB)
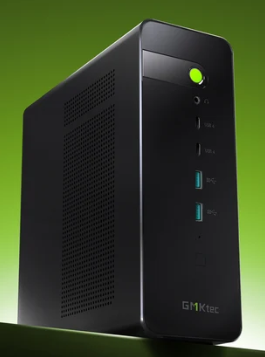
- 192GBユニファイドメモリ
- GPU割当 最大160GB
- gpt-oss-120b と 20b を同時に常駐
- 生成速度 約60 tok/s(見込み)
103万9,840円 192GB+2TB/発売時価格
EVO-X2(128GB)
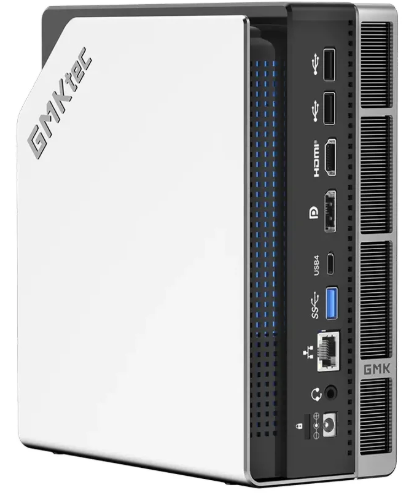
- 128GBユニファイドメモリ
- GPU利用実績 約82GiB
- gpt-oss-120b を実運用中
- 生成速度 約57 tok/s
58万3,000円 128GB+2TB
tok/s は1秒あたりに生成する文字のまとまり(トークン)の数です。数値が大きいほど回答が速く表示されます。
部門規模なら、
Windows機と弊社開発の軽量LLMでも運用できます
全社で使うのか、ひとつの部門で使うのかによって、必要な機器は変わります。 部門規模であれば、専用機を用意しなくても、Core i7以上のWindows機で弊社が開発した軽量LLMを動かせます。
全社・複数の用途で
EVO-X5 Pro
大型モデルと中型モデル、検索用モデルを同時に常駐。用途ごとにモデルを使い分けられます。
中堅企業の標準構成
EVO-X2
gpt-oss-120b を常駐。社内の問い合わせ・文書検索の中心として使えます。
部門規模で手軽に
Windows機+軽量LLM
Core i7以上のWindows機に、弊社開発の軽量LLMを組み込んで運用します。
構成の一覧
| 項目 | EVO-X5 Pro(192GB) | EVO-X2(128GB) | Windows機 |
|---|---|---|---|
| CPU | AMD Ryzen AI MAX+ 395 | AMD Ryzen AI MAX+ 395 | Core i7以上 |
| ストレージ | 2TB | 2TB | ― |
| OS | Ubuntu 26.04 | Ubuntu 26.04 | Windows |
| GPUドライバ | Mesa RADV(Vulkan) | Mesa RADV(Vulkan) | ― |
| 推論エンジン | llama.cpp(Vulkanバックエンド) | llama.cpp(Vulkanバックエンド) | SOOS_lite に 独自に組み込み (弊社開発の軽量LLM) |
| チャット画面 | Open WebUI(Docker) | Open WebUI(Docker) | |
| 常駐モデル | gpt-oss-120b gpt-oss-20b Qwen3.6-35B-A3B bge-m3検索用 |
gpt-oss-120b | |
| RAG | SOOS_lite 組み込みMySQL | SOOS_lite 組み込みMySQL | SOOS_lite に組み込み |
RAG(検索拡張生成)は、社内の文書やデータを検索し、その内容をもとにAIが回答する仕組みです。
LLM構築いたします
機器の選定から、社内で使い始めるまでを一括でお手伝いします。
- ご相談・用途の確認使う人数・部門、扱う文書やデータ、使い方をお伺いします。
- 機器の選定・手配規模と予算に合わせて、EVO-X5 Pro/EVO-X2/Windows機から最適な構成をご提案します。
- 推論環境の構築OS・GPUドライバ・推論エンジン・チャット画面を設定し、常時稼働させます。
- モデルの導入用途に合ったモデルを選び、常駐させて動作を確認します。
- RAGの構築社内の文書やデータを取り込み、自社の情報で答えられるようにします。
- 社内展開・運用サポート操作説明を行い、導入後の運用もサポートします。
LLM構築のご相談は
「自社の規模ならどの構成がよいか」「今あるWindows機で動かせるか」など、構成のご相談からお気軽にどうぞ。 訪問・オンライン(Zoom等)いずれも対応いたします。
お問い合わせページのご用件で「LLM構築について」を選んでお送りください。
記載の製品名・社名は各社の商標または登録商標です。価格・仕様は参考値であり、変更される場合があります。 生成速度は弊社環境での実測値または見込み値で、モデル・設定・入力内容により異なります。
バナースペース
